

Bất kỳ Data Engineer nào từng vận hành các pipeline thu thập dữ liệu thị trường (giá cổ phiếu, tỷ giá thương mại điện tử, dữ liệu on-chain) với cường độ cao đều quen thuộc với kịch bản này: Đang trong phiên giao dịch sôi động, hệ thống cảnh báo Slack đột ngột báo đỏ rực. Hàng loạt log trả về mã lỗi HTTP 429 Too Many Requests. Khi toàn bộ worker chia sẻ chung một cổng ra internet (Egress IP), hệ thống đích chỉ mất vài giây để nhận diện sự bất thường và khóa chặt truy cập.
Nhiều đội ngũ cố gắng xử lý bằng cách nâng cấp CPU hoặc RAM cho máy chủ, hy vọng sức mạnh điện toán sẽ giải quyết được vấn đề. Tuy nhiên, nút thắt cổ chai thực sự nằm ở kiến trúc mạng và cơ chế phân bổ request. Để duy trì luồng dữ liệu liên tục mà không bị rate-limit, việc thiết lập một mạng lưới Datacenter Proxy phân tán trên nhiều node VPS là phương án giải quyết bài bản từ tầng hạ tầng.
Vậy cấu trúc mạng lưới này hoạt động ra sao, làm thế nào để tự động hóa quy trình quản lý IP, và triển khai các thuật toán retry hiện đại để hệ thống thực sự thực chiến? Hãy cùng mổ xẻ chi tiết qua từng tầng kiến trúc.
Ám ảnh 429 Too Many Requests và nút thắt của hệ thống Single Node
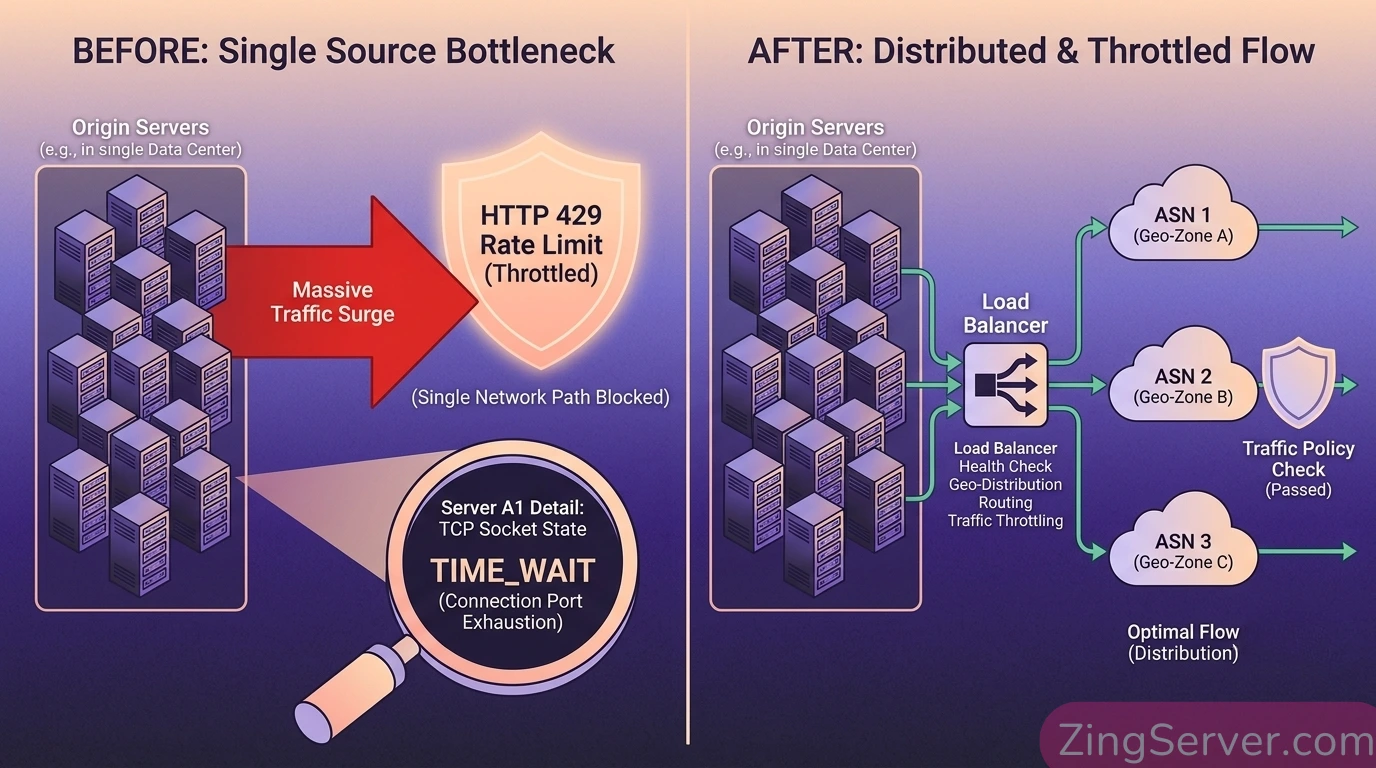
Lỗi HTTP 429 không báo hiệu hệ thống đích bị hỏng (như lỗi 5xx), mà là một thông điệp chủ động từ WAF (Web Application Firewall) hoặc API Gateway nhằm bảo vệ tài nguyên của họ khỏi bị cạn kiệt do các luồng traffic dồn dập.
Cơ chế Rate-Limit của server đích hoạt động ra sao?
Các máy chủ hiện đại thường áp dụng các thuật toán khống chế lưu lượng nhằm giới hạn luồng truy cập từ một địa chỉ IP cụ thể, do đó hệ thống cần dùng Datacenter Proxy chống rate limit để giải quyết bài toán này:
- Fixed Window (Cửa sổ cố định): Giới hạn số lượng request trong một khoảng thời gian (ví dụ: 100 request/phút). Bộ đếm sẽ đặt lại về 0 khi sang phút mới. Cơ chế này thường gặp rắc rối với các đợt bùng nổ lưu lượng (burst) ở ranh giới các phút.
- Token Bucket (Xô token): Linh hoạt hơn khi cấp phát token theo thời gian thực. Mỗi request tiêu tốn một token. Khi xô hết token, server trả về lỗi 429 lập tức, nhưng vẫn cho phép các đợt bùng nổ lưu lượng ngắn nếu xô đang đầy.
- WAF chặn lọc tại biên (Edge Filtering): Các hệ thống như AWS WAF hay Cloudflare không chờ request chạm đến server backend. Chúng phân tích hành vi ở tầng mạng biên và áp dụng lệnh cấm tạm thời dựa trên IP hoặc danh tiếng (Reputation).
Tại sao nâng cấp phần cứng (CPU/RAM) vô dụng trước lỗi 429?
Nhiều developer lầm tưởng rằng pipeline chạy chậm là do thiếu tài nguyên. Thực chất, giới hạn nằm ở các yếu tố mạng:
- Trần hiệu suất do chống bot (Anti-bot): Để sinh tồn trước các hệ thống bảo mật, pipeline phải chèn thêm độ trễ (sleep) và giảm số lượng luồng đồng thời (concurrency). Việc này khiến CPU và RAM luôn ở trạng thái nhàn rỗi. Tăng cấu hình máy chủ không giúp vượt qua rào cản IP.
- Kiệt quệ cổng kết nối (Ephemeral Port Exhaustion): Dưới tải trọng cao, hàng chục nghìn kết nối TCP kết thúc sẽ rơi vào trạng thái
TIME_WAITở cấp độ hệ điều hành. Khi cạn kiệt dải cổng khả dụng, máy chủ sẽ tự từ chối kết nối mới dù RAM vẫn còn trống. - Danh tiếng IP (IP Reputation): Một máy chủ cấu hình cao với 128GB RAM vẫn dùng chung một địa chỉ IP Datacenter. WAF sẽ khóa toàn bộ traffic đi ra từ IP đó ngay khi phát hiện tần suất bất thường.

Góc nhìn thực tế: Datacenter Proxy và cuộc chiến chống Anti-bot
Trước khi đi sâu vào cấu hình, chúng ta cần nhìn nhận khách quan về giới hạn của Datacenter Proxy. Rất nhiều tài liệu coi đây là viên đạn bạc cho data pipeline, nhưng thực tế môi trường triển khai lại phức tạp hơn.
Ưu điểm tốc độ nhưng đi kèm rủi ro nhận diện cao
Các IP thuộc Datacenter Proxy (thuê từ AWS, DigitalOcean, Hetzner, Vultr…) mang lại băng thông lớn (thường từ 100 Mbps đến 1 Gbps) và chi phí vận hành trên mỗi node được tối ưu tốt. Tuy nhiên, các hệ thống anti-bot tinh vi (như DataDome, Akamai, Cloudflare Turnstile) có sẵn cơ sở dữ liệu ASN (Autonomous System Number) để lọc ra các IP thương mại này.
Đối với các trang web có mức độ bảo mật cao, tỷ lệ thành công (success rate) khi sử dụng Datacenter Proxy thường chỉ dao động ở mức 20% – 40%. Hệ thống đích biết rõ người dùng bình thường hiếm khi truy cập từ một phòng máy chủ, do đó họ sẽ liên tục đẩy ra các thử thách CAPTCHA hoặc chặn cứng bằng mã 403 Forbidden.
Sự linh hoạt của Residential và ISP Proxy
Nếu mục tiêu của Data Pipeline là thu thập dữ liệu từ các nền tảng thương mại điện tử quy mô rộng hoặc mạng xã hội được bảo vệ nghiêm ngặt, kỹ sư hệ thống cần cân nhắc kết hợp thêm:
- Residential Proxy: Sử dụng địa chỉ IP thật từ các thiết bị dân dụng (do các nhà mạng như VNPT, Viettel, Comcast cung cấp). Độ tin cậy cao, tỷ lệ thành công có thể lên tới 85% – 95%, giúp pipeline hoạt động tự nhiên như người dùng thật.
- ISP Proxy (Static Residential): Là sự lai tạo mang tính tối ưu. IP được cung cấp bởi các nhà mạng viễn thông nhưng lại được lưu trữ tại các Data Center. Điểm giá trị của ISP Proxy nằm ở khả năng giữ IP tĩnh vô thời hạn (infinite static IP retention). Tính năng này biến chúng thành lựa chọn phù hợp cho các luồng thu thập dữ liệu dạng chuỗi, nhiều bước (như quy trình checkout giỏ hàng) hoặc khi tương tác với các API yêu cầu token xác thực gắn chặt với một địa chỉ IP.
Đối với các API công khai, web dữ liệu có mức bảo vệ trung bình, hoặc các tác vụ thu thập dữ liệu thô, mạng lưới Datacenter Proxy tự xây dựng vẫn mang lại hiệu quả cao về mặt chi phí vận hành.
Kiến trúc 3 lớp của một mạng lưới Datacenter Proxy chuyên nghiệp
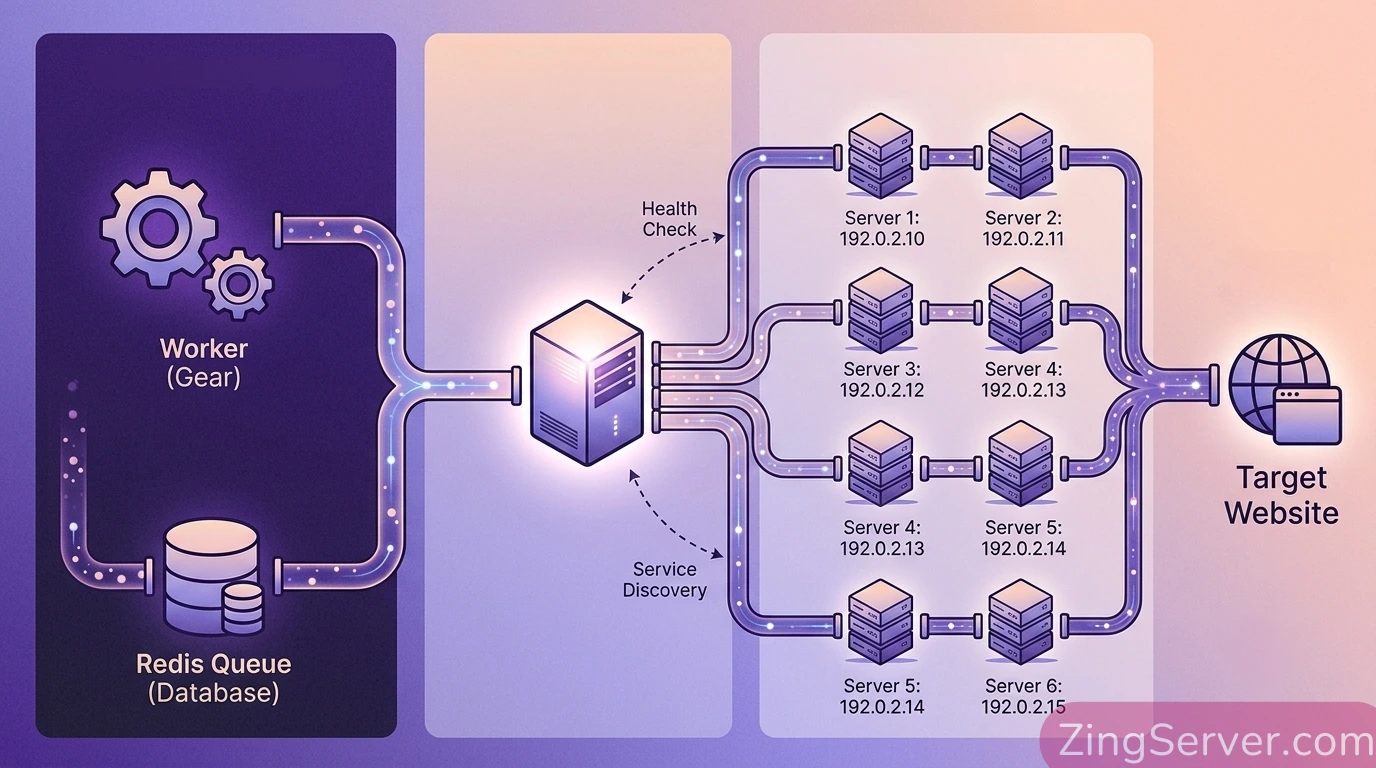
Thay vì để các worker gọi trực tiếp đến API đích, một hệ thống thu thập dữ liệu chuyên nghiệp sẽ định tuyến luồng traffic qua mạng lưới proxy được thiết kế theo kiến trúc 3 lớp (3-tier Star Architecture).
Lớp 1: Tầng ứng dụng (Client / Data Pipeline & Queue)
Đây là nơi chứa logic thu thập dữ liệu, được viết bằng Python, Go hoặc Node.js. Các worker nhận tác vụ từ Message Queue (như Redis, RabbitMQ, Kafka) và khởi tạo các request. Ở lớp này, code của developer không cần bận tâm đến việc xử lý IP nào đang bị khóa. Toàn bộ request sẽ được trỏ về một endpoint nội bộ (Gateway).
Lớp 2: Tầng điều phối (Proxy Gateway / Entry Node)
Đóng vai trò là trung tâm điều phối lưu lượng. Một Internal Proxy Gateway hiện đại sẽ:
- Tiếp nhận luồng request từ Lớp 1.
- Quản lý phiên (Session Management) để giữ nguyên một IP cho các luồng request cần tính liên tục (Sticky Session).
- Sử dụng thuật toán cân bằng tải (Load Balancing) để phân phát request xuống mạng lưới máy chủ lối ra.
- Tự động khám phá dịch vụ (Service Discovery) và kiểm tra sức khỏe mạng (Health Check) nhằm tự động thêm/bớt các node IP mà không làm gián đoạn pipeline.
Lớp 3: Tầng lối ra (Exit Nodes / Proxy Mesh)
Đây là tập hợp hàng chục hoặc hàng trăm node VPS chi phí tối ưu phân tán ở nhiều trung tâm dữ liệu. Mỗi node sẽ chạy phần mềm proxy (như 3proxy, Squid) để tiếp nhận yêu cầu từ Gateway và sử dụng IP Public tĩnh của nó để giao tiếp với website mục tiêu, làm phân tán rủi ro bị khóa IP diện rộng. Có thể nói đây là yếu tố then chốt khi thiết lập Proxy Socks5 cho API trong Data Pipeline.
Triển khai cấu hình tự động hóa mạng lưới proxy
Các phương pháp cũ thường yêu cầu người quản trị phải khai báo tĩnh từng địa chỉ IP của các node VPS vào file cấu hình. Khi mạng lưới phình to lên hàng trăm node, hoặc khi một VPS bị nhà cung cấp thu hồi IP, việc sửa file thủ công và khởi động lại Gateway sẽ tạo ra thời gian chết (downtime). Các hệ thống quy mô mở rộng giải quyết bài toán này bằng tự động hóa.
Đa dạng hóa ASN (Autonomous System Number)
Nguyên tắc quan trọng trước khi cấu hình: Hãy phân bổ các node VPS ra nhiều nhà cung cấp khác nhau. WAF có thể chặn toàn bộ một hệ thống định tuyến (ASN-level Blocking) nếu phát hiện lưu lượng bất thường. Bằng cách thuê VPS kết hợp từ Vultr, Linode, Hetzner, OVH…, rủi ro sẽ được rải đều. Nếu một ASN bị WAF của trang đích chặn, lưu lượng sẽ tự động điều hướng sang các ASN của nhà cung cấp khác.
Tự động hóa Proxy Pool với Scrapoxy và Consul
Thay vì cấu hình tĩnh, kỹ sư hệ thống nên áp dụng cơ chế tự động khám phá dịch vụ (Dynamic Service Discovery).
Ứng dụng Scrapoxy
Scrapoxy là một mã nguồn mở được thiết kế riêng cho tác vụ quản lý proxy pool. Nó hoạt động như một API mạnh mẽ cho phép:
- Tự động giao tiếp với API của các nhà cung cấp Cloud (AWS, DigitalOcean, Vultr) để tự động tạo (spin up) hoặc xóa (destroy) các VPS node khi cần xoay IP mới.
- Cung cấp tính năng Blackhole: Nếu một IP nhận quá nhiều mã 429 hoặc bị block, Scrapoxy tự động loại IP đó, xóa VPS cũ và khởi tạo một VPS mới với IP hoàn toàn an toàn mà developer không cần can thiệp thủ công.
- Quản lý cân bằng tải luồng mạng.
Kết hợp HAProxy và Consul
Nếu đội ngũ muốn ứng dụng kiến trúc cấu hình HAProxy xoay Proxy Socks5 mạnh mẽ ở Layer 4, việc tích hợp với Consul (công cụ service mesh của HashiCorp) là một hướng đi chuẩn mực.
- Khi khởi tạo một VPS Exit Node mới (có cài sẵn 3proxy), một Agent trên VPS đó sẽ gửi tín hiệu đăng ký dịch vụ về Consul Server.
- HAProxy được cấu hình với Consul Template. Mỗi khi Consul ghi nhận có node proxy mới (hoặc node ngừng hoạt động), nó tự động cập nhật danh sách backend của HAProxy và reload động cấu hình dưới nền (hitless reload) mà không làm rơi bất kỳ gói tin TCP nào đang chạy.
- Code pipeline ở Lớp 1 chỉ cần kết nối đến một địa chỉ cụ thể của HAProxy. Mọi việc luân chuyển IP phía sau diễn ra hoàn toàn trong suốt.
Xử lý lỗi 429: Thử lại (Retry) thông minh với thư viện Python
Khi pipeline phân tán lưu lượng ra hàng chục IP, đôi lúc một IP vô tình chạm ngưỡng giới hạn và nhận về lỗi 429. Cách hệ thống phản ứng lúc này quyết định việc dải IP đó có bị chặn vĩnh viễn hay không.
Tôn trọng Header Retry-After
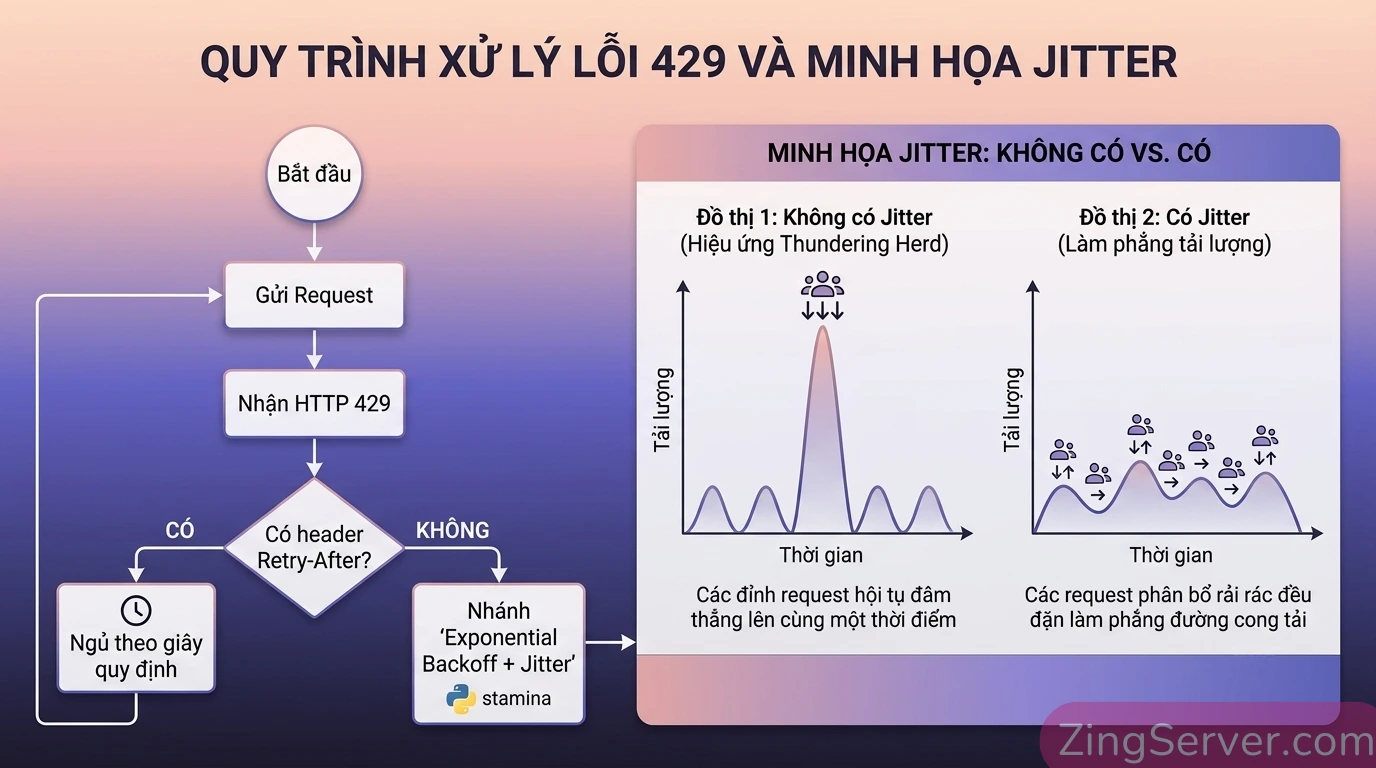
Hầu hết các server khi trả về lỗi 429 đều đính kèm một HTTP Header là Retry-After. Nó báo hiệu số giây (hoặc mốc thời gian cụ thể) mà client bắt buộc phải chờ. Việc phớt lờ tín hiệu này và liên tục gửi request bồi thêm sẽ khiến WAF đánh giá nguồn truy cập là lưu lượng độc hại và tiến hành khóa IP. Việc đọc và tuân thủ Retry-After là quy tắc thiết yếu.
Rủi ro của Retry Storm (Cơn bão thử lại)
Nếu server không gửi kèm Retry-After, developer thường tự thiết lập thời gian chờ (backoff). Tuy nhiên, nếu dùng các đoạn code đệ quy (recursive call) viết tay, hoặc thiết lập thời gian ngủ cố định (ví dụ 5 giây), hiện tượng Thundering Herd (Hiệu ứng bầy đàn) sẽ xảy ra.
Khi một cụm API bị nghẽn, hàng trăm worker sẽ cùng nhận lỗi 429. Nếu tất cả cùng ngủ đúng 5 giây, thì 5 giây sau, hàng trăm worker lại đồng loạt thức dậy và ập vào server cùng một thời điểm. Server vừa mới phục hồi được một chút lại tiếp tục bị nghẽn tải.
Ứng dụng thư viện Stamina cho Exponential Backoff & Jitter
Để làm phẳng biểu đồ request, các kỹ sư phần mềm hiện nay áp dụng thuật toán Exponential Backoff (tăng thời gian chờ theo cấp số nhân) kết hợp Jitter (độ trễ ngẫu nhiên). Thay vì tự code đệ quy rườm rà dễ gây tràn bộ nhớ, hệ sinh thái Python cung cấp sẵn các thư viện tiêu chuẩn công nghiệp hiệu quả.
Điển hình là thư viện stamina (hoặc tenacity). Các thư viện này tự động bao bọc function bằng decorator an toàn, tính toán khoảng thời gian chờ bắt đầu từ 100ms, tăng theo cấp số nhân và tự động thêm một khoảng ngẫu nhiên (Jitter) từ 0 đến 1 giây ở mỗi bước.
Đoạn code Python thực chiến tích hợp stamina và httpx:
import httpx
import stamina

# Cấu hình retry: Tối đa 5 lần, chờ tối đa 45 giây.
# Stamina tự động tính base delay 100ms, áp dụng Jitter và nhân lũy thừa.
@stamina.retry(on=httpx.HTTPStatusError, attempts=5, timeout=45)
async def fetch_data(client, url):
    response = await client.get(url)

    # Bắt lỗi 429
    if response.status_code == 429:
        retry_after = response.headers.get("Retry-After")
        if retry_after:
            print(f"Server yêu cầu nghỉ. Đang áp dụng Retry-After: {retry_after}s")
            # Logic xử lý chờ riêng nếu có header
            # stamina.sleep(int(retry_after)) # (Pseudo code điều hướng)

        # Kích hoạt Exception để stamina tự động chạy vòng lặp Backoff + Jitter
        response.raise_for_status()

    response.raise_for_status()
    return response.json()

# Hàm chính sử dụng client trỏ về Proxy Gateway
async def run_pipeline():
    proxies = {"http://": "http://IP_PROXY_GATEWAY:8080"}
    async with httpx.AsyncClient(proxies=proxies) as client:
        data = await fetch_data(client, "https://api.target-website.com/data")
        print("Thu thập thành công!")
Bằng cách sử dụng thư viện chuẩn, mã nguồn trở nên gọn gàng, loại bỏ nguy cơ tràn stack và tự động bẻ gãy sự đồng bộ hóa request, giúp dải IP hoạt động bền bỉ, mượt mà hơn.
Tối ưu hóa Kernel Linux (Sysctl) toàn diện cho node Gateway
Một thiếu sót thường gặp khi thiết lập mạng lưới Proxy là chỉ cài đặt phần mềm (như Nginx, HAProxy) rồi đưa thẳng vào production. Khi phải gánh tải hàng chục nghìn luồng concurrent request thu thập dữ liệu (burst traffic), node Gateway sẽ ngừng trệ ở tầng hệ điều hành trước khi chạm đến giới hạn của CPU hay RAM.
Để biến máy chủ Linux thành một nền tảng mạng thực thụ, việc can thiệp sâu vào cấu hình kernel thông qua sysctl là yêu cầu bắt buộc, giúp bạn tránh việc phải tìm cách sửa lỗi VPS Linux mất kết nối bằng eBPF chuyên sâu từ tầng Kernel về sau.
Mở file /etc/sysctl.conf trên máy chủ Gateway và bổ sung các thông số tối ưu mạng sau:
# 1. Nâng trần File Descriptor (Quan trọng cho Proxy Gateway)
# Mỗi kết nối mạng (socket) Linux tính là 1 file. Nếu thiếu, báo lỗi "Too many open files"
fs.file-max = 2000000

# 2. Mở rộng hàng đợi (Backlog Queues) để hứng Burst Traffic
# Tăng kích thước hàng đợi chứa các kết nối TCP chờ được Nginx/HAProxy xử lý
net.core.somaxconn = 65535
# Tăng số lượng gói tin được phép xếp hàng ở mức độ Card Mạng (Network Interface)
net.core.netdev_max_backlog = 65535
# Tăng hàng đợi chứa các luồng SYN (đang chờ thiết lập kết nối 3 bước)
net.ipv4.tcp_max_syn_backlog = 65535

# 3. Tái sử dụng socket và mở rộng dải cổng (Ephemeral Ports)
# Giúp hệ thống giải phóng và tái sử dụng các port đang ở trạng thái TIME_WAIT
net.ipv4.tcp_tw_reuse = 1
# Mở rộng dải port tạm thời cấp cho các luồng request đi ra mạng lưới Exit Nodes
net.ipv4.ip_local_port_range = 1024 65535

# 4. Kiểm soát tắc nghẽn mạng (TCP BBR)
# Quản lý luồng gói tin thông minh, chống nghẽn mạng hiệu quả khi truyền tải payload lớn
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
Sau khi lưu file, chạy lệnh sau để cấu hình có hiệu lực:
sudo sysctl -pĐặc biệt, việc bật thuật toán kiểm soát tắc nghẽn BBR (Bottleneck Bandwidth and Round-trip propagation time) là một thủ thuật chuyên sâu. Gateway sẽ phân tích thời gian phản hồi vòng (round-trip) để điều tiết lưu lượng truyền tải thông minh, giảm thiểu tình trạng rớt gói tin (packet loss) khi proxy phải gửi về lượng dữ liệu JSON/HTML lớn.
Giám sát hạ tầng (Monitoring) và Alerting
Một hệ thống phân tán sẽ trở thành hộp đen nếu đội ngũ thiếu đi các chỉ số đo lường (Observability) chuẩn xác. Dựa vào log console của worker là chưa đủ. Các kiến trúc sư hệ thống thường tích hợp hệ thống giám sát VPS bằng Prometheus Grafana để thu thập metrics từ Proxy Gateway và Exit Nodes.
Các chỉ số (Metrics) mang tính sống còn cần theo dõi:
- Tỷ lệ lỗi 429 (Rate Limited Rate): Thu thập thông qua
http_requests_total{status="429"}. Nếu biểu đồ này có xu hướng ngóc đầu lên, hệ thống cảnh báo (Alertmanager) cần bắn thông báo về Slack để kỹ sư kịp thời giảm nhịp độ thu thập hoặc nạp thêm IP mới vào pool. - Độ trễ phân vị P95/P99 (Latency Percentiles): Việc theo dõi P95/P99 giúp nhận diện 5% luồng request chậm trễ đang hoạt động ra sao. Độ trễ P95 tăng vọt là dấu hiệu băng thông của nhà cung cấp VPS đang bị nghẽn, hoặc hệ thống đích bắt đầu phản hồi chậm.
- Bạn hoàn toàn có thể giám sát băng thông datacenter proxy bằng grafana để kiểm soát tham số này.
- Tỷ lệ IP đang hoạt động (Active Proxy Pool Size): Đo lường số lượng IP còn an toàn trong tổng số IP. Nếu Scrapoxy báo cáo pool size bị sụt giảm quá nhanh (do nhiều IP bị đưa vào diện blacklist), hệ thống cần tự động điều phối spin-up các VPS dự phòng để đắp vào.
Câu hỏi thường gặp (FAQ)
1. Xây dựng mạng lưới Datacenter Proxy cần bao nhiêu node VPS để bắt đầu?
Khoảng 5-10 node cho giai đoạn thử nghiệm. Sau đó dựa vào tỷ lệ lỗi 429 thực tế trên Grafana để scale (mở rộng) dần lên.
2. Hệ thống đích có dễ dàng chặn Datacenter Proxy không?
Có. Tuy nhiên, việc rải đều request thông qua Load Balancer, kết hợp đa dạng ASN và thiết lập Jitter sẽ giảm thiểu triệt để nguy cơ này.
3. Tại sao không dùng thẳng Residential Proxy cho Data Pipeline?
Chi phí tính theo GB băng thông cao và độ trễ mạng lớn. Mạng lưới proxy xây dựng trên hạ tầng Datacenter mang lại mức chi phí tối ưu hơn hẳn cho dữ liệu khối lượng lớn.
4. Cấu hình Sysctl cho Gateway có thực sự bắt buộc không?
Bắt buộc nếu pipeline chạy cường độ cao. Bỏ qua bước này sẽ khiến hệ điều hành ngừng trệ vì cạn kiệt dải cổng kết nối hoặc tràn file descriptor trước cả khi CPU bị quá tải.
Kết luận
Xử lý triệt để lỗi 429 Too Many Requests đòi hỏi một tư duy thiết kế hệ thống phân tán thay vì chỉ tập trung nâng cấp cấu hình phần cứng. Bằng cách chia tách Data Pipeline ra khỏi lớp giao tiếp mạng thông qua mạng lưới Datacenter Proxy 3 tầng, kỹ sư dữ liệu sẽ làm chủ được luồng lưu lượng của mình.
Sự kết hợp giữa cơ chế khám phá dịch vụ tự động của Consul/Scrapoxy, tư duy ứng dụng thư viện retry thông minh (stamina), kỹ thuật tuning Kernel (BBR, Somaxconn) và giám sát chặt chẽ bằng Prometheus tạo nên một bộ khung hạ tầng vững chắc. Hệ thống không chỉ giúp Data Pipeline vận hành trơn tru, giấu cấu trúc mạng trước các bộ lọc WAF mà còn mang lại khả năng linh hoạt chuyển đổi sang Residential/ISP Proxy bất kỳ lúc nào mục tiêu thay đổi chính sách bảo mật.