

Việc bưng một khối lượng dữ liệu khổng lồ (hàng trăm GB đến hàng TB) từ AWS S3, Object Storage hay các API nội bộ về máy chủ để xử lý luôn là một bài toán hóc búa với bất kỳ Data Engineer nào. Thực tế triển khai thường rất phũ phàng: bạn mở bảng điều khiển giám sát và thấy tài nguyên CPU của máy chủ gần như ngồi chơi (chỉ loanh quanh ở mức 5-10%), trong khi data pipeline thì kẹt cứng hàng giờ đồng hồ chỉ vì phải chờ phản hồi mạng.
Đỉnh điểm của sự ức chế xảy ra khi bạn cố gắng cấu hình tăng số lượng luồng (threads) để ép hệ thống kéo dữ liệu nhanh hơn. Ngay lập tức, màn hình console báo đỏ rực với hàng loạt mã lỗi HTTP 429 Too Many Requests, hoặc tệ hơn là dải IP của máy chủ bị tường lửa (WAF) từ phía nhà cung cấp khóa chặn.
Làm thế nào để bẻ gãy nút thắt cổ chai I/O này (bạn có thể tham khảo thêm hướng dẫn xóa sổ I/O Bottleneck để tối ưu tốc độ VPS Windows Server 2025 bằng Storage Spaces Direct), vắt kiệt hiệu năng phần cứng mà vẫn đảm bảo pipeline luân chuyển dữ liệu mượt mà qua các bộ lọc khắt khe của đối tác?
Sự kết hợp giữa kiến trúc mạng Datacenter Proxy làm lớp điều phối lưu lượng và engine DuckDB 2.0 trên VPS chính là câu trả lời mang tính bước ngoặt. Hệ thống này định hình lại quy chuẩn thiết kế Data Pipeline ra sao? Làm cách nào để cấu hình chúng hoạt động trơn tru cùng nhau mà không làm sập Kernel của máy chủ?

Ám ảnh của Data Engineer: I/O nghẽn mạng và HTTP 429 Too Many Requests
Trước khi đi sâu vào giải pháp, chúng ta cần mổ xẻ những giới hạn kỹ thuật chí mạng khiến các hệ thống phân tích dữ liệu truyền thống liên tục thất bại khi mở rộng quy mô (scale).
Sự lãng phí của cơ chế đọc đồng bộ (Synchronous I/O)
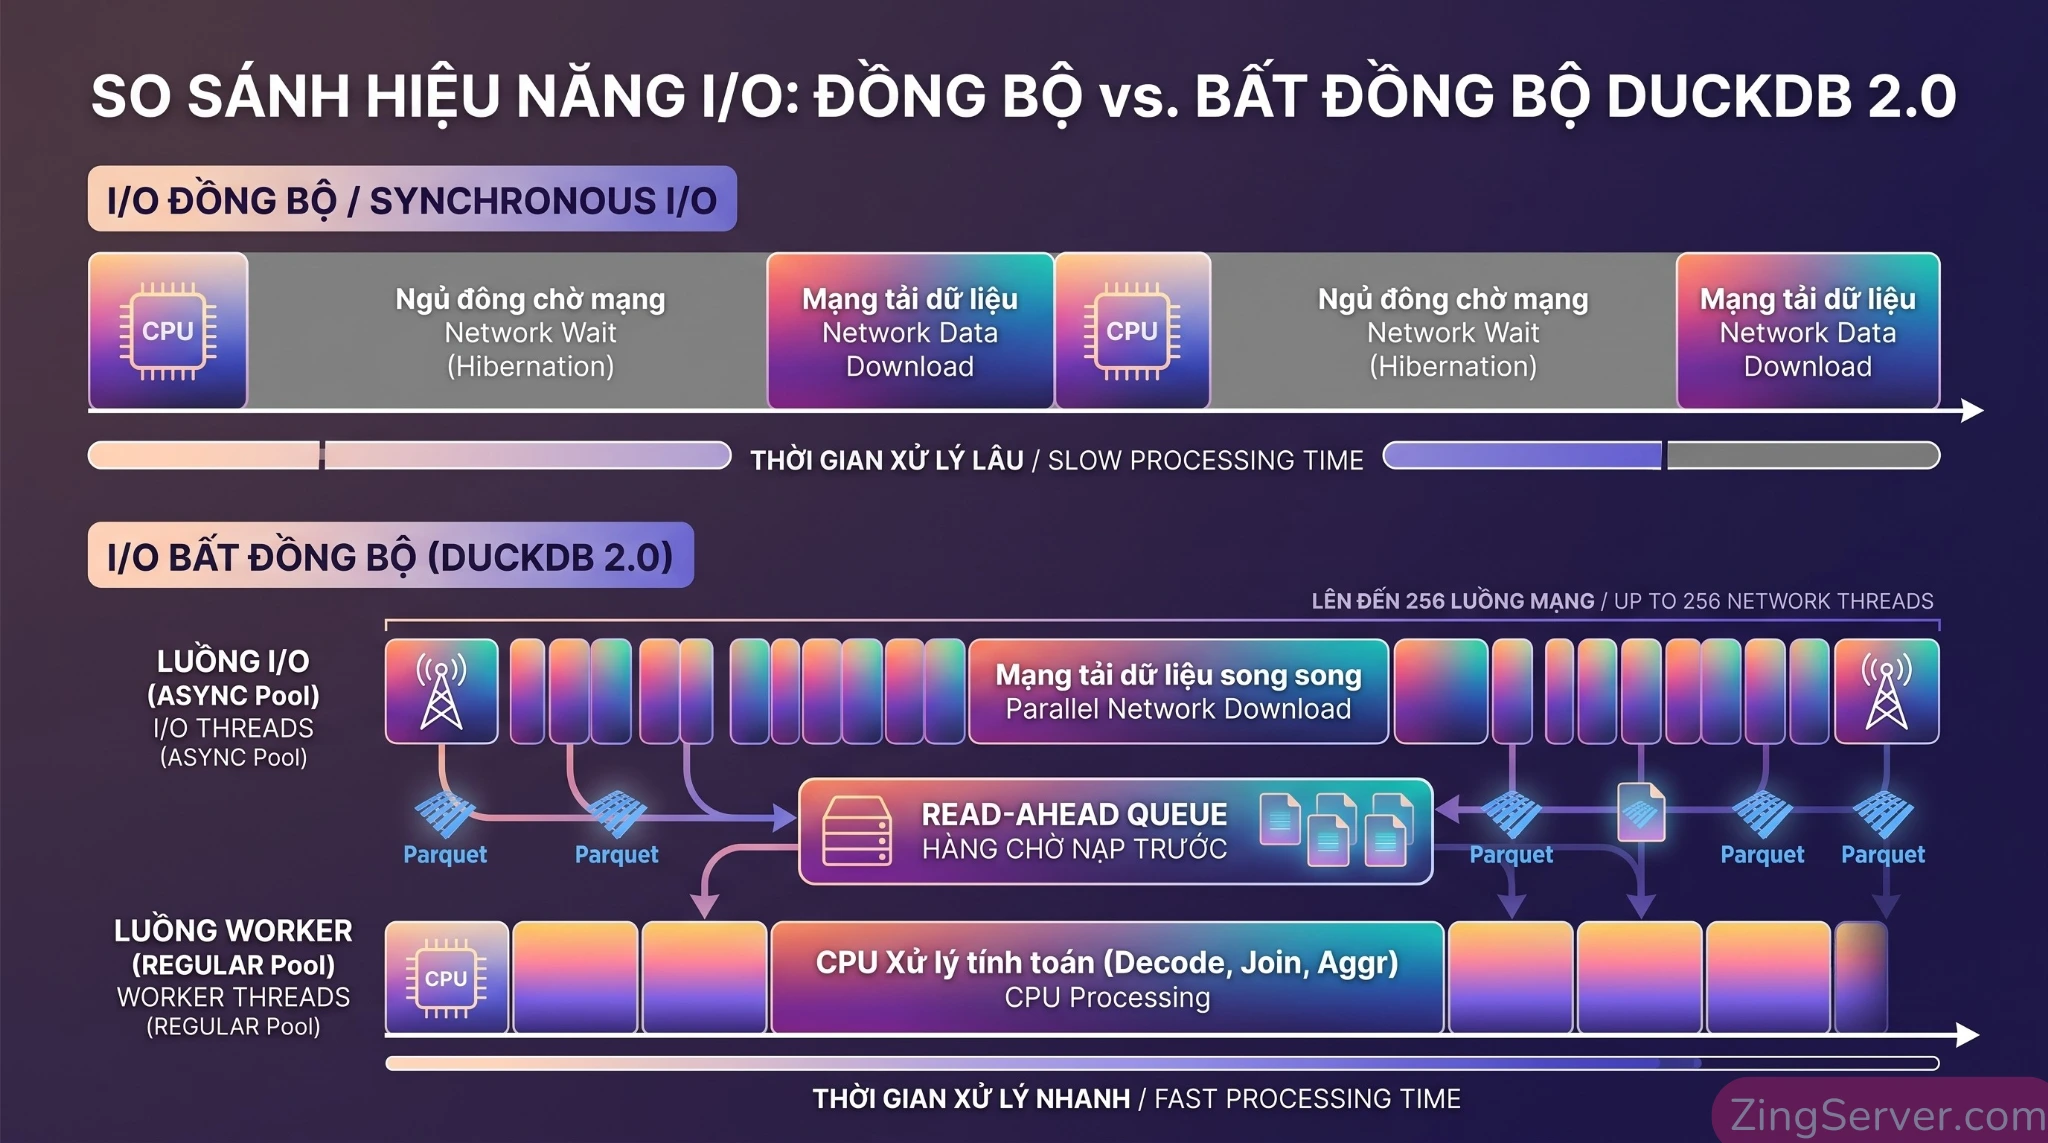
Trong nhiều năm qua, các công cụ xử lý dữ liệu thường nạp file qua mạng bằng cơ chế đồng bộ. Khi pipeline thực thi, mỗi worker thread (luồng xử lý) gửi một yêu cầu HTTP đi và lập tức bị khóa (Thread Blocking). Luồng này rơi vào trạng thái ngủ đông hoàn toàn cho đến khi byte dữ liệu cuối cùng được tải về, sau đó mới thức dậy để tiến hành giải mã (decode) và tính toán.
Khâu nạp dữ liệu và khâu xử lý diễn ra theo kiểu nối đuôi nhau, không thể gối đầu (overlap) lên nhau. Hậu quả là tài nguyên CPU bị lãng phí nghiêm trọng. Theo các bài đo lường hiệu năng (benchmark) thực tế, khi chạy một truy vấn nặng trên cụm 64 cores CPU qua mạng S3 bằng cơ chế cũ, chỉ có trung bình khoảng 6 cores thực sự hoạt động. Khả năng khai thác băng thông mạng cũng vô cùng nghèo nàn vì hệ thống không duy trì đủ lượng yêu cầu đang chờ (in-flight requests) trên đường truyền.
Ám ảnh Rate-limit và sự kiệt quệ tài nguyên Kernel
Để bù đắp cho sự chậm chạp của luồng đồng bộ, phương án thường được các developer áp dụng là: đẩy số lượng request song song lên con số hàng nghìn. Tuy nhiên, khi toàn bộ lưu lượng khổng lồ này xuất phát từ một địa chỉ IP đơn lẻ của máy chủ VPS, thảm họa sẽ lập tức xảy ra:
- Tường lửa chặn đứng (HTTP 429): Các API Gateway hiện đại giám sát giới hạn tốc độ (rate-limit) rất gắt gao. Một lượng lớn request ồ ạt đổ về từ một IP sẽ bị hệ thống phân tích hành vi đánh dấu là spam và trả về lỗi 429, cắt đứt toàn bộ kết nối của pipeline.
- Cạn kiệt cổng kết nối (Ephemeral Port Exhaustion): Ở tải trọng cao, việc liên tục mở và đóng kết nối TCP khiến hàng ngàn socket bị kẹt ở trạng thái
TIME_WAIT. Tình trạng này kéo dài sẽ làm cạn kiệt dải cổng tạm thời của hệ điều hành Linux, khiến VPS không thể khởi tạo thêm bất kỳ kết nối nào ra bên ngoài, gây sập cục bộ (local crash) mà không rõ nguyên nhân phần cứng.
Giải phẫu sức mạnh của DuckDB 2.0 trong Data Pipeline
Để giải quyết tận gốc vấn đề nghẽn cổ chai, hệ sinh thái DuckDB đã giới thiệu phiên bản 2.0 (mã danh Cyanoptera) mang theo một cuộc đại tu kiến trúc lõi, đặc biệt tối ưu cho các workload làm việc trực tiếp qua mạng.
Cơ chế Async I/O: Tách bạch luồng tải dữ liệu và CPU decode
DuckDB 2.0 phá vỡ rào cản đồng bộ bằng cách chia hệ thống thành hai nhóm luồng hoạt động hoàn toàn độc lập:
- REGULAR Pool (Worker Threads): Nhóm luồng này được sinh ra chỉ để phục vụ tính toán nặng (như giải mã định dạng Parquet/CSV, Join bảng, Aggregation). Chúng không bao giờ phải dừng lại để chờ phản hồi từ mạng.
- ASYNC Pool (I/O Threads): Một nhóm luồng mạng chuyên biệt (có thể cấu hình lên đến 256 threads). Nhiệm vụ của chúng là liên tục gọi API, duy trì hàng chục kết nối HTTP song song để lấp đầy băng thông mạng.
Chìa khóa của kiến trúc này là Hàng chờ tải trước (Read-Ahead Queue). Khi REGULAR pool đang bận rộn tính toán khối dữ liệu hiện tại, ASYNC pool đã âm thầm kéo sẵn các khối dữ liệu tiếp theo về bộ đệm RAM. Sự gối đầu mượt mà giữa CPU và I/O mạng giúp thời gian truy xuất các file dữ liệu khổng lồ giảm xuống mức ấn tượng (bạn có thể xem thêm hướng dẫn triển khai DuckDB trên VPS Ubuntu 26.04 để xây dựng server OLAP hiệu năng cao nhằm hiểu rõ hơn về nền tảng này).
Thực tế ghi nhận, tốc độ xử lý file CSV trên S3 có thể tăng vọt đáng kể, rút ngắn thời gian từ hàng chục phút xuống chỉ còn vài chục giây.
Quack Protocol & Stateless Query: Giải phóng kết nối mạng
Không dừng lại ở một engine phân tích cục bộ nhúng (in-process), DuckDB 2.0 mang đến giao thức mạng Quack, biến máy chủ của bạn thành một trung tâm cung cấp dữ liệu. Quack truyền tải dữ liệu bằng định dạng nhị phân nội bộ (application/duckdb), bảo toàn trọn vẹn các cấu trúc dữ liệu phức tạp (ARRAY, STRUCT) mà không cần bước chuyển đổi (serialize) sang định dạng JSON trung gian vốn rất tiêu tốn tài nguyên.
Một tính năng đột phá của kiến trúc này là khả năng chạy Stateless Queries (Truy vấn không trạng thái) thông qua hàm quack_query. Thay vì phải thực hiện chuỗi thao tác cồng kềnh (Gắn database -> Kết nối -> Truy vấn -> Ngắt kết nối), worker của bạn chỉ cần gửi thẳng một lệnh duy nhất.
Cách gọi không trạng thái này giúp các worker trong Data Pipeline không phải duy trì phiên làm việc lâu dài, loại bỏ hoàn toàn rủi ro rò rỉ kết nối (connection leak) nếu một worker bất ngờ bị crash giữa chừng.
Cú pháp thực thi cực kỳ gọn gàng và thanh lịch:
-- Client gọi truy vấn trực tiếp vào Server mà không cần thiết lập trạng thái ATTACH/CONNECT
FROM quack_query(
    'quack:duckdb.your-domain.com',
    'SELECT category, SUM(amount) FROM analytics_table GROUP BY ALL',
    token = 'secret_token_here'
);
Định vị Datacenter Proxy: Lớp Traffic Control và Egress Management
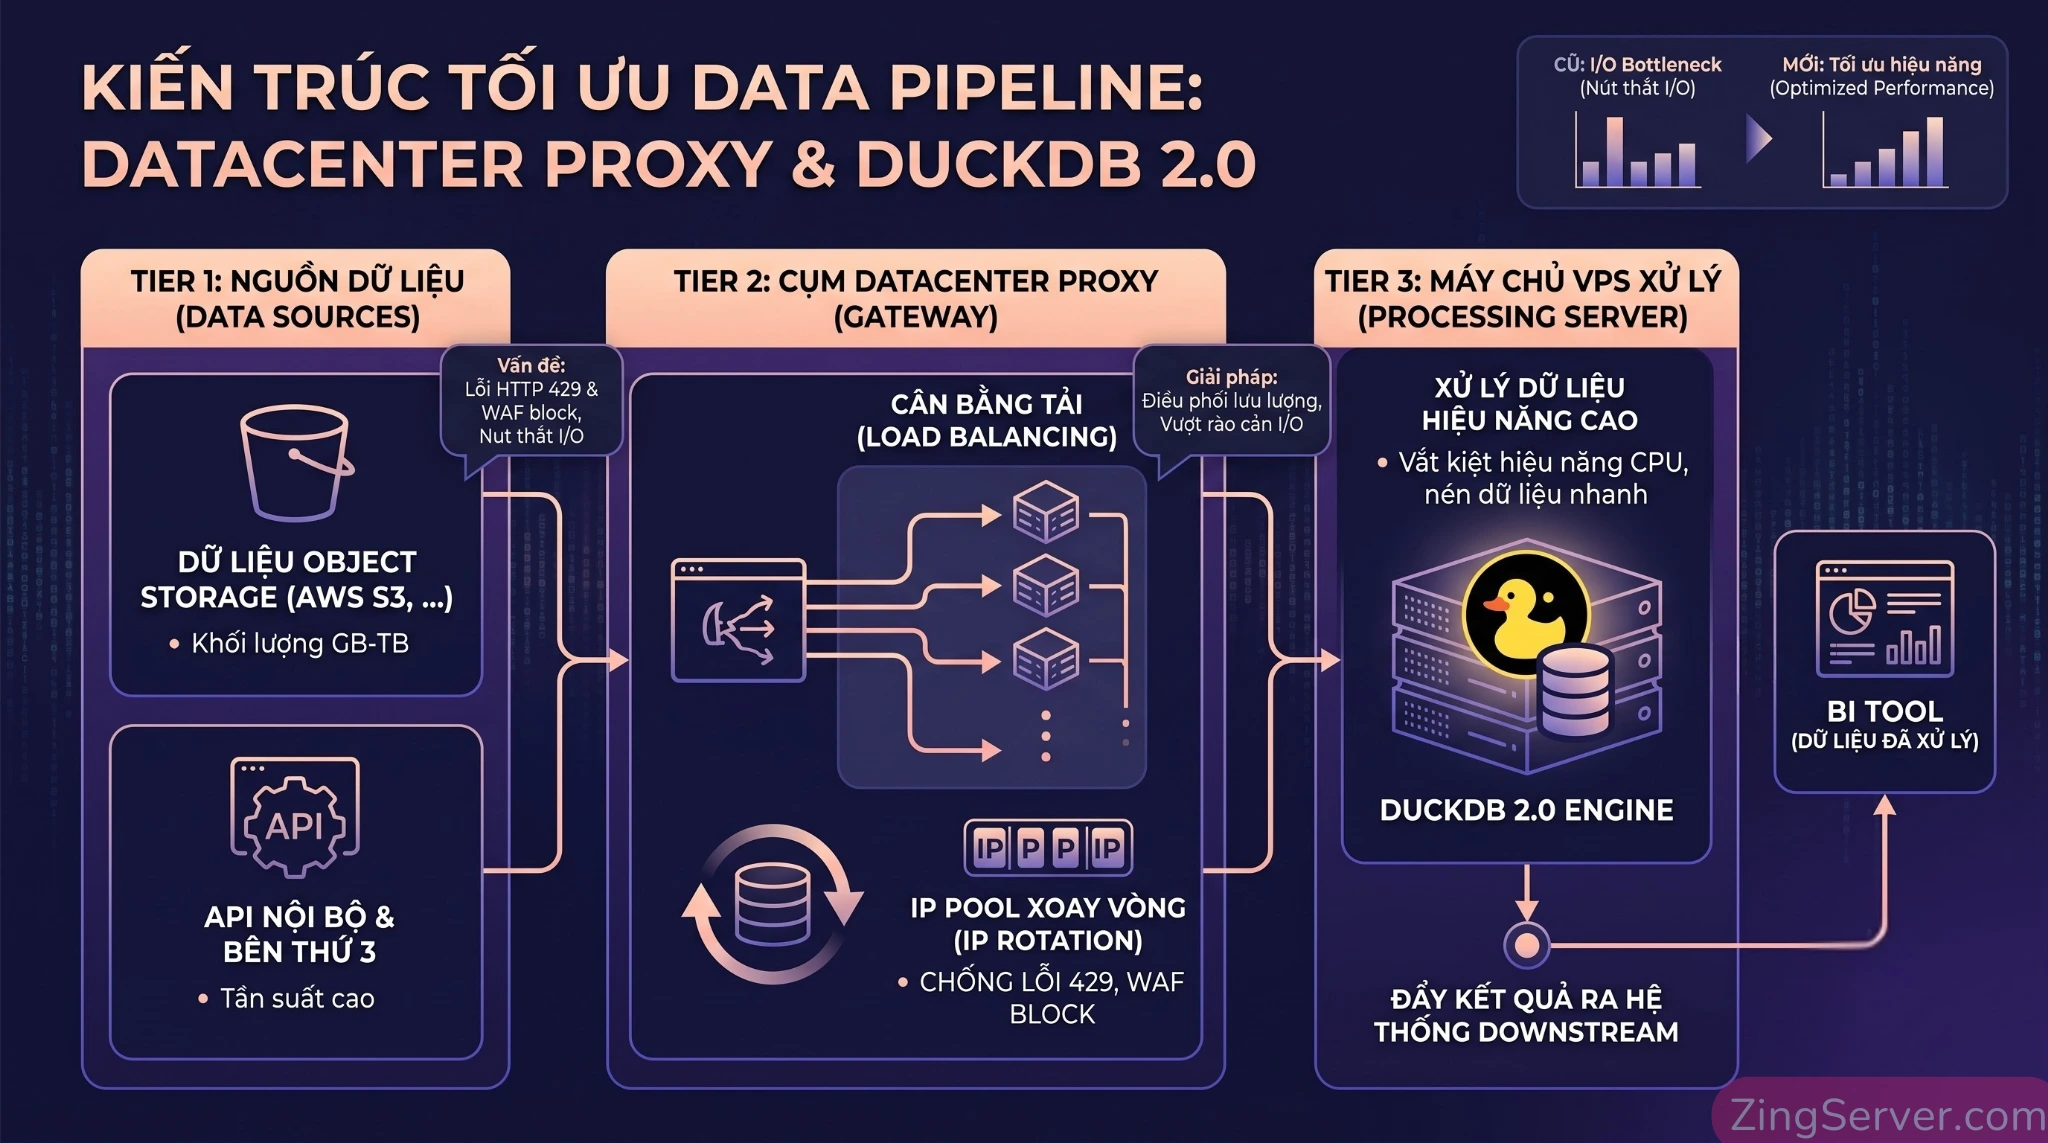
Nhiều developer có thói quen sử dụng Proxy như một thủ thuật để lách rate-limit bằng cách liên tục đổi IP bất chấp. Tư duy này vô tình làm hệ thống trở nên mong manh, dễ bị các WAF (Web Application Firewall) nhận diện hành vi rà soát liên tục và chặn toàn bộ dải mạng. Để tránh rủi ro sập hệ thống (bạn có thể tham khảo thêm cách phân tán tải lượng Data Pipeline thông qua việc cấu hình mạng lưới Datacenter Proxy trên nhiều node VPS để tránh lỗi 429), Datacenter Proxy cần được định vị là một Lớp quản lý Egress và Traffic Control (Điều phối lưu lượng đầu ra).
Quản lý Connection Pool và phân luồng Egress
Thay vì để các worker trên VPS tự do kết nối ra ngoài internet theo cách hỗn loạn, hãy định tuyến chúng qua một kiến trúc bài bản:
- Lớp Application: Nơi DuckDB khởi tạo các request kéo dữ liệu.
- Lớp Proxy Gateway: Hoạt động như một bộ cân bằng tải (Load Balancer). Tại đây, cụm máy chủ sẽ chịu trách nhiệm phân phối lưu lượng, quản lý số lượng kết nối đang mở và điều tiết tốc độ.
- Lớp Exit Nodes: Các IP của Datacenter Proxy được phân bổ trải đều trên nhiều dải ASN (Autonomous System Number) khác nhau. Việc đa dạng hóa ASN là tấm khiên vững chắc giúp phân tán rủi ro bị WAF khóa IP diện rộng, đảm bảo luồng dữ liệu luôn thông suốt.
Xử lý rate-limit chủ động với Queueing và Retry Backoff
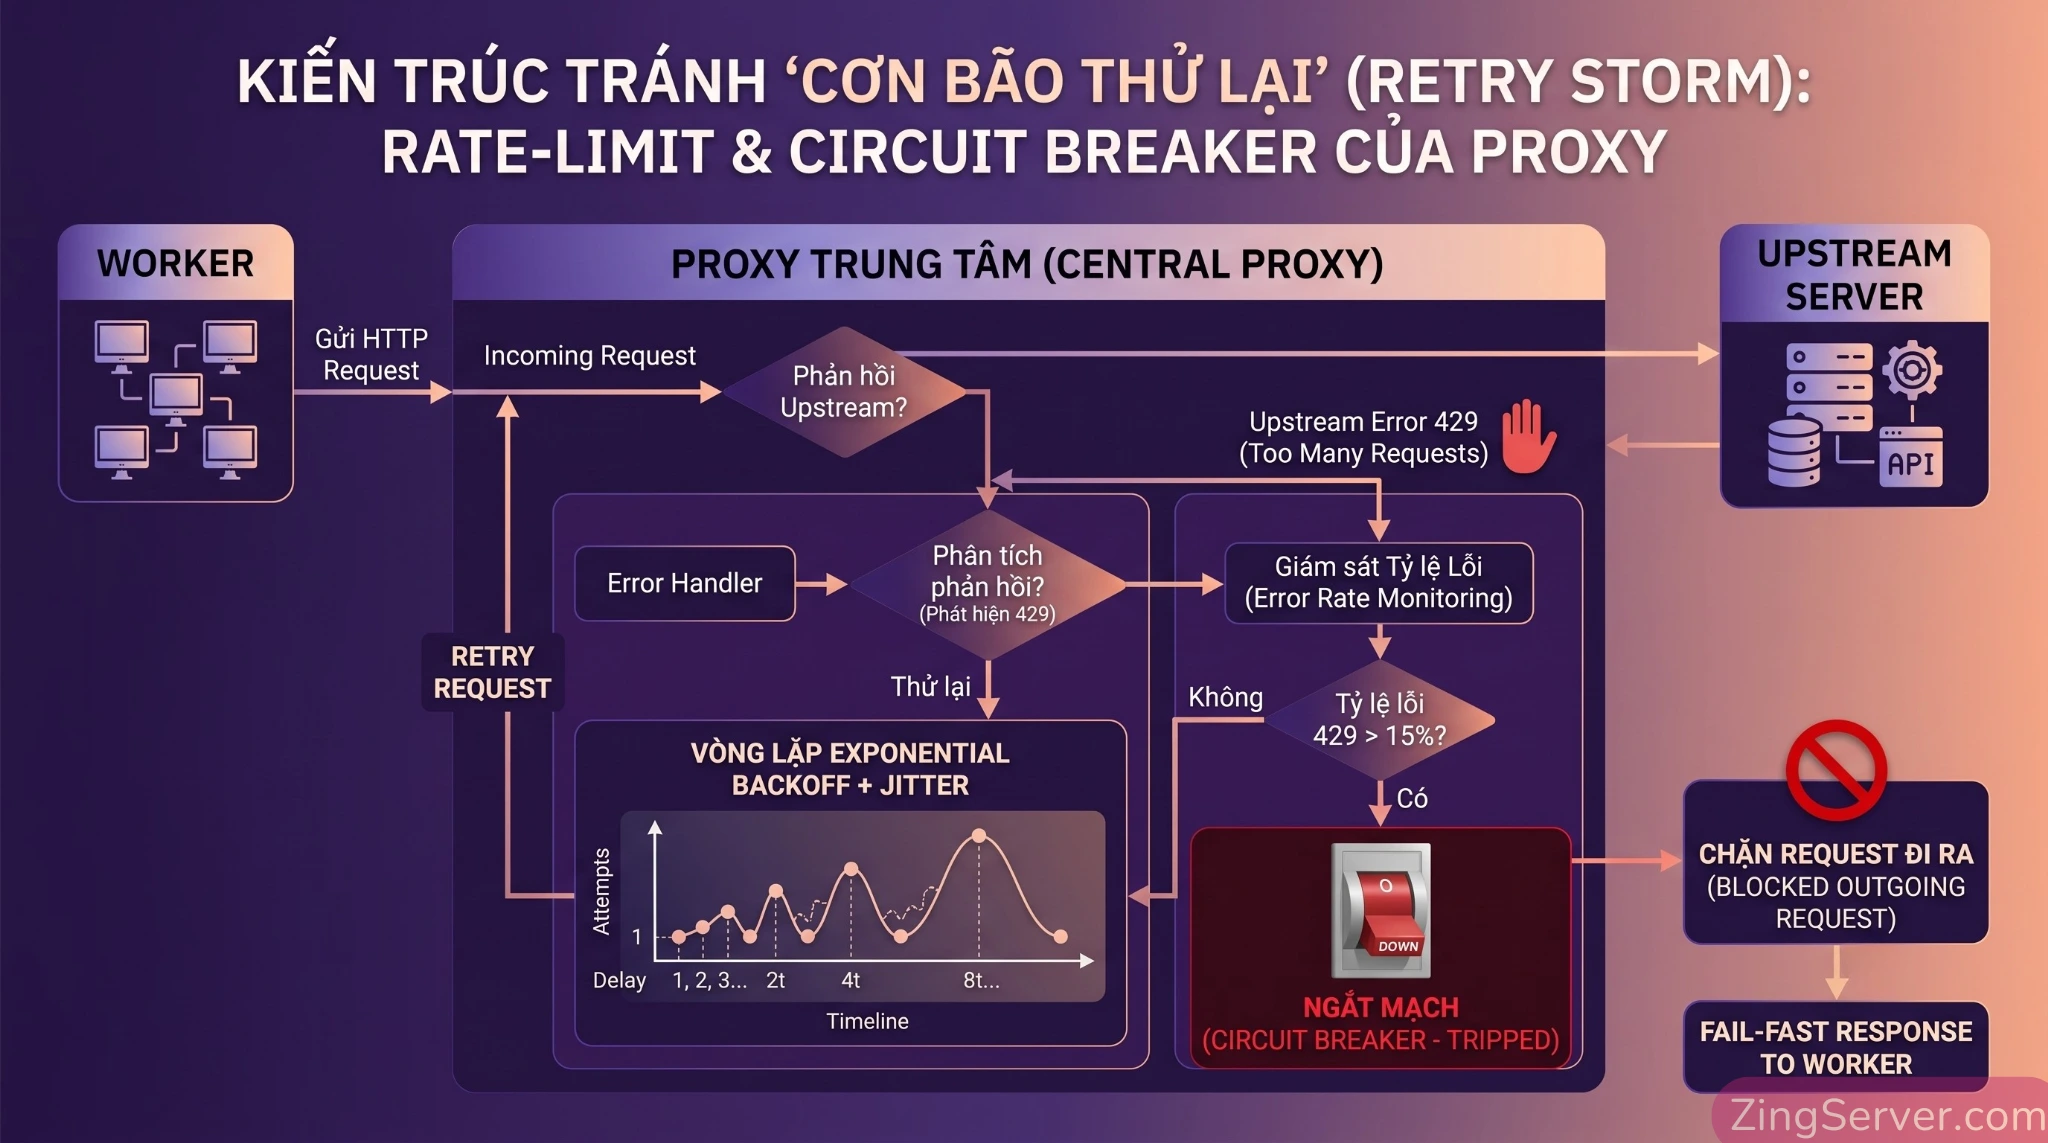
Khi hệ thống upstream bắt đầu có dấu hiệu quá tải, nếu toàn bộ worker của bạn đồng loạt thử lại (retry) ngay lập tức, chúng sẽ tạo ra cơn bão thử lại (Retry Storm) đánh sập máy chủ đích. Lớp Proxy trung tâm điều tiết nhịp độ này bằng cách:
- Tôn trọng header
Retry-After: Phân tích phản hồi từ máy chủ đích và bắt buộc hệ thống chờ đúng khoảng thời gian được yêu cầu trước khi kết nối lại. - Áp dụng Exponential Backoff và Full Jitter: Nếu không có header hướng dẫn, hệ thống tự động giãn cách thời gian thử lại theo cấp số nhân, kết hợp cùng yếu tố ngẫu nhiên (Jitter) để bẻ gãy sự đồng bộ, làm phẳng biểu đồ truy cập.
- Ngắt mạch thông minh (Circuit Breaker): Hệ thống chỉ tự động retry với các lỗi nghẽn mạng tạm thời (như 429, 502, 503). Nếu phát hiện lỗi client-side do truy cập sai quyền (như 401 Unauthorized hay 403 Forbidden), kết nối sẽ bị ngắt (fail-fast) ngay lập tức để bảo vệ tài nguyên hệ thống.
Thực chiến: Triển khai DuckDB 2.0 trên VPS kết hợp Proxy Pool và AWS S3 Express
Dưới đây là bản thiết kế cấu hình (blueprint) mang tính ứng dụng cao để đưa hệ thống vào vận hành thực tế. Bản cấu hình này khai thác triệt để các cập nhật công nghệ hiện đại, giải quyết rành mạch những điểm mù về mạng và bộ nhớ.
Tối ưu tài nguyên VPS, cấu hình RAM và bộ đệm tràn đĩa
Lỗi kinh điển khi chạy engine phân tích trên Linux VPS là để mặc định hệ thống sử dụng 80% RAM. Khi bộ nhớ chạm trần do các phép tính toán JOIN hoặc SORT phức tạp, hệ điều hành sẽ kích hoạt OOM Killer (Out-Of-Memory) tiêu diệt tiến trình (bạn có thể tham khảo cách tối ưu VRAM khi chạy fine tune LLM trên VPS GPU tránh lỗi OOM), làm sập data pipeline không báo trước. Bạn cần khống chế memory_limit ở mức 50% – 60% tổng RAM vật lý.
Bên cạnh đó, DuckDB 2.0 trên VPS mang đến một tham số vô cùng giá trị cho bài toán I/O mạng: enable_external_file_cache = true. Khi bộ đệm nội bộ của VPS đầy, thay vì phải vứt bỏ các block dữ liệu mạng khỏi RAM và tốn băng thông kéo lại cho lần truy vấn tiếp theo, hệ thống sẽ ghi tạm (spill) thẳng các block mạng này xuống ổ cứng NVMe cục bộ. Tính năng này giúp pipeline giảm thời gian đọc lại một file mạng từ hàng chục giây xuống chỉ còn vài mili-giây.
-- Khống chế mức RAM an toàn (Ví dụ: VPS 8GB RAM thì cấu hình 4GB)
SET memory_limit = '4GB';
SET threads = 2;

-- Trỏ vùng nhớ tạm sang ổ cứng NVMe tốc độ cao
SET temp_directory = '/mnt/nvme_data/tmp';

-- Kích hoạt bộ đệm tràn đĩa cho file mạng (Giảm triệt để việc tải lại dữ liệu từ mạng)
SET enable_external_file_cache = true;

-- Tự động điều tiết độ sâu hàng chờ Read-Ahead cho mạng
SET read_ahead_depth = -1;
SET preserve_insertion_order = false;
Tích hợp S3 Express One Zone và AWS Extension
Để giải quyết triệt để độ trễ mạng, việc đọc từ các bucket S3 tiêu chuẩn đôi khi chưa đủ đáp ứng yêu cầu khắt khe của dữ liệu lớn. Giải pháp tối ưu là sử dụng AWS S3 Express One Zone (chuẩn lưu trữ có độ trễ cực thấp). Bằng cách đặt VPS và Bucket S3 Express trong cùng một Availability Zone, kết hợp cùng Async I/O, pipeline của bạn sẽ đạt tốc độ truyền tải cực lớn.
Thay vì cấu hình thông tin xác thực AWS dạng văn bản thô (plain-text) rủi ro qua HTTP Proxy như các phiên bản cũ, giải pháp bảo mật là sử dụng Native AWS Extension. Extension này tự động nhận diện thông tin xác thực an toàn (từ môi trường IAM của VPS) và khai thác sức mạnh HTTP Range Requests để chỉ tải đúng dải byte cần thiết.
Lưu ý: Endpoint của S3 Express bắt buộc phải được khai báo qua Secret, và tên bucket trong truy vấn phải tuân thủ chuẩn định dạng có chứa Availability Zone ID.
-- Tải và kích hoạt AWS Extension
INSTALL aws; LOAD aws;

-- Tự động nạp thông tin xác thực bảo mật từ OS/IAM
CALL load_aws_credentials();

-- Khai báo ENDPOINT của S3 Express qua Secret
CREATE SECRET s3_express (
    TYPE s3,
    REGION 'us-east-1',
    ENDPOINT 's3express-use1-az1.us-east-1.amazonaws.com'
);

-- Tên bucket phải đi kèm zone ID theo định dạng chuẩn của AWS
SELECT * FROM read_parquet('s3://my-express-bucket--use1-az1--x-s3/data/*.parquet');
Khai báo Datacenter Proxy và vũ khí HTTP Connection Caching
Đối với các nguồn dữ liệu API bên ngoài cần đi qua Proxy, bạn sử dụng CREATE SECRET kết hợp tham số SCOPE để định tuyến chính xác traffic. Bên cạnh đó, một điểm thiết lập cực kỳ quan trọng mà nhiều Data Engineer bỏ quên là httpfs_connection_caching.
Mặc định, mỗi request mạng sẽ mở một kết nối TCP độc lập, kéo theo chi phí handshake TCP/TLS nặng nề, làm tăng độ trễ (latency). Việc bật caching kết nối giúp hệ thống tái sử dụng socket có sẵn, đẩy nhanh tốc độ khi pipeline gọi API liên tục.
-- Kích hoạt tái sử dụng kết nối mạng (Giảm độ trễ TCP/TLS handshake)
SET httpfs_connection_caching = true;

-- Định tuyến traffic của API Vendor đi qua Datacenter Proxy Pool
CREATE SECRET proxy_api_vendor (
    TYPE http,
    HTTP_PROXY 'http://192.168.1.50:8080',
    HTTP_PROXY_USERNAME 'user_proxy',
    HTTP_PROXY_PASSWORD 'pass_proxy',
    SCOPE 'https://api.vendor-data.com'
);
🔥 Chú ý Troubleshooting cứu mạng: Rất nhiều kỹ sư hệ thống có thói quen thiết lập biến môi trường
export HTTP_PROXY=...trực tiếp trên hệ điều hành Linux và đinh ninh mọi công cụ sẽ tự động nhận diện. Cần lưu ý rõ: DuckDB KHÔNG tự động đọc biến môi trường mạng này. Để dữ liệu thực sự đi qua Proxy, việc khai báo thông quaCREATE SECREThoặc lệnhSET http_proxylà bước bắt buộc. Nắm vững tiểu tiết này sẽ giúp team kỹ thuật tiết kiệm nhiều giờ đồng hồ mệt mỏi để gỡ lỗi (debug) kết nối mạng!
Cấu hình hạ tầng mạng: Caddy Server và tinh chỉnh Kernel Linux
Để biến VPS thành một trạm trung chuyển dữ liệu chịu tải cao, bản thân hệ điều hành và Web Server cũng cần được cấu hình chuyên sâu.
Setup Caddy Server tự động hóa SSL cho Quack Server
Thay vì sử dụng Nginx truyền thống đòi hỏi nhiều dòng cấu hình và thao tác cấp phát chứng chỉ Let’s Encrypt thủ công qua Certbot, kiến trúc hạ tầng hiện đại ưu tiên sử dụng Caddy Server. Caddy tự động quản lý SSL/TLS và giúp file cấu hình trở nên tinh gọn đáng ngạc nhiên.
Đối với giao thức Quack truyền kết quả truy vấn dưới dạng stream liên tục, bạn chỉ cần tắt bộ đệm (buffering) bằng tham số flush_interval -1 và nới rộng kích thước gói tin.
# /etc/caddy/Caddyfile
duckdb.your-domain.com {
    reverse_proxy 127.0.0.1:9494 {
        # Bắt buộc: Tắt buffering để stream kết quả Quack ngay lập tức
        flush_interval -1
    }

    request_body {
        # Nới rộng kích thước gói tin cho các truy vấn phức tạp hoặc lệnh INSERT
        max_size 256MB
    }
}
Tinh chỉnh Sysctl chống cạn kiệt cổng kết nối (Local Crash)
Ở phần đầu bài viết, chúng ta đã nhắc đến nỗi đau cạn kiệt socket TCP (TIME_WAIT). Để máy chủ Proxy Gateway (như Caddy hoặc HAProxy) trên VPS có thể chịu tải hàng chục ngàn request cùng lúc, bạn bắt buộc phải nới lỏng giới hạn Kernel Linux. Việc thiếu File Descriptor hoặc hàng đợi TCP sẽ khiến VPS báo lỗi Too many open files trước cả khi chạm ngưỡng CPU.
💡 Lệnh tinh chỉnh Kernel Linux chống sập cục bộ
Hãy thêm các cấu hình sau vào
/etc/sysctl.conftrên VPS Gateway và chạy lệnhsysctl -pđể áp dụng:# Nâng trần File Descriptor để mở hàng vạn socket song song fs.file-max = 2000000 # Mở rộng hàng đợi kết nối TCP net.core.somaxconn = 65535 net.core.netdev_max_backlog = 65535 # Mở rộng tối đa dải cổng tạm thời (Ephemeral Ports) net.ipv4.ip_local_port_range = 1024 65535 # Tái sử dụng socket đang kẹt ở TIME_WAIT net.ipv4.tcp_tw_reuse = 1
Data Modeling: Biến VARIANT và Parquet thành bộ đôi giải phóng I/O
Kiến trúc hạ tầng mạng dù được tinh chỉnh mạnh mẽ đến đâu cũng cần được song hành cùng một mô hình dữ liệu (Data Modeling) khoa học để cắt giảm Egress I/O ngay từ gốc rễ. Việc nạp trực tiếp hàng chục GB file JSON thô qua mạng là một thao tác vắt kiệt sức mạnh CPU chỉ cho quá trình phân tích cú pháp (parsing).
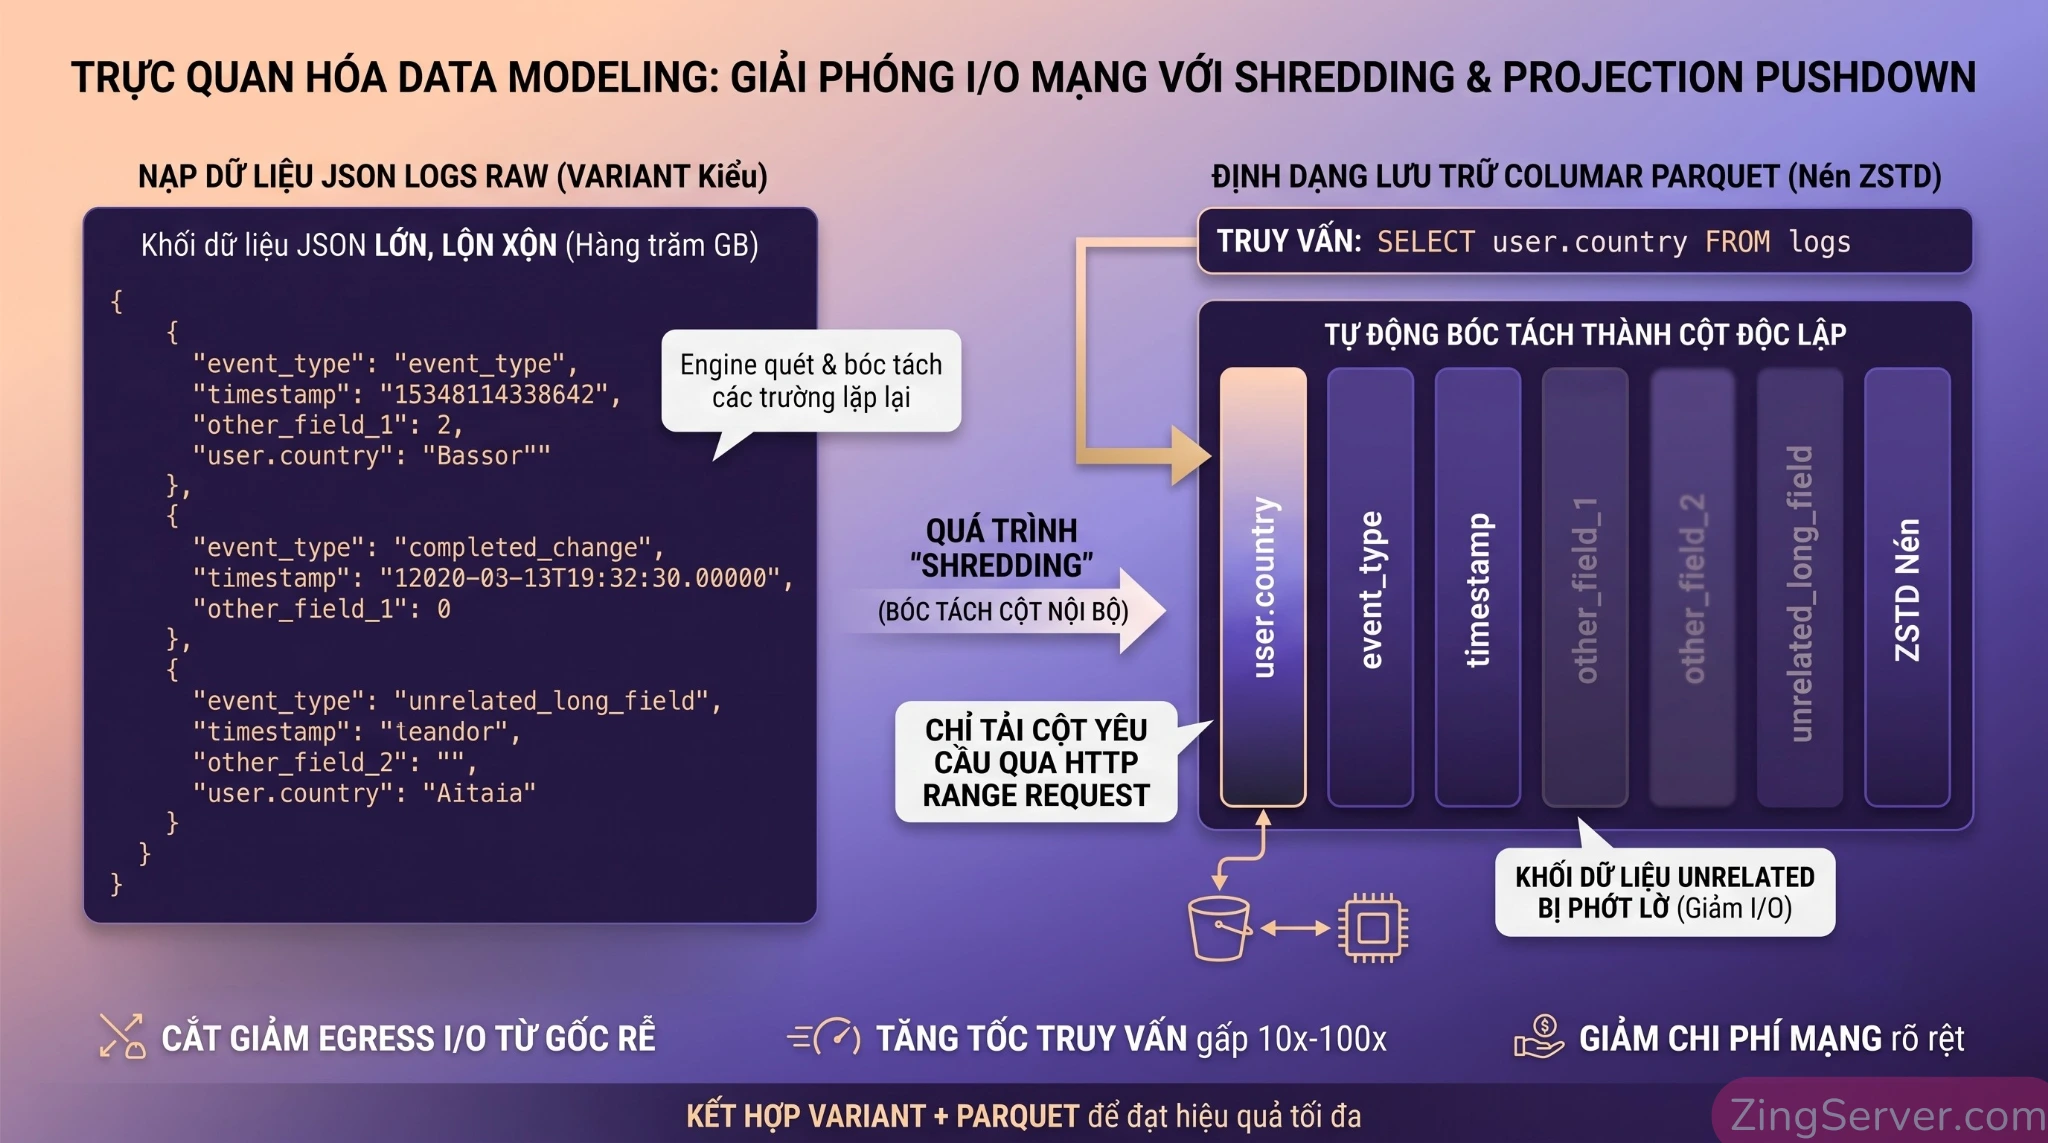
Phiên bản mới cung cấp kiểu dữ liệu VARIANT kết hợp cơ chế Shredding (Bóc tách cột nội bộ). Khi nạp log JSON, engine quét và tự động trích xuất các trường dữ liệu xuất hiện lặp lại nhiều lần (ví dụ: user.country, timestamp, event_type) thành các cột vật lý độc lập (sub-columns) bên dưới nền.
Sự kỳ diệu thực sự xảy ra khi kết hợp VARIANT với định dạng lưu trữ dạng cột như Parquet (nén ZSTD). Hệ thống kích hoạt cơ chế Projection Pushdown cực kỳ sắc bén. Nếu truy vấn phân tích của bạn chỉ yêu cầu trường user.country để đếm số người dùng, trình phân tích (query planner) sẽ gửi tín hiệu qua HTTP Range Request để chỉ tải đúng dải byte chứa cột đó từ mạng.
Khối JSON khổng lồ chứa các trường không liên quan còn lại bị phớt lờ hoàn toàn. Cấu trúc kết hợp này giúp nén dung lượng lưu trữ hiệu quả, giảm chi phí mạng rõ rệt và tăng tốc độ xử lý lên nhiều lần so với các truy vấn text truyền thống.
Công thức tính Concurrency an toàn và giám sát hệ thống
Để lớp Datacenter Proxy hoạt động trơn tru với sự ổn định cao, lượng kết nối đồng thời (Concurrency) gửi đi cần được thiết lập dựa trên định mức tính toán kỹ lưỡng, tránh tình trạng spam vô tội vạ gây nghẽn upstream.
- Quy tắc tính toán Semaphore: Sử dụng công thức
(Tốc độ request mục tiêu / Giới hạn RPS của Server đích) * 1.2. - Khoảng trống dự phòng (Headroom): Khuyến nghị khống chế lượng request đang xử lý (in-flight requests) ở mức 60% – 70% ngưỡng chịu tải của hệ thống API đích. Khoảng trống 30% – 40% còn lại đóng vai trò như một bộ giảm xóc, giúp pipeline của bạn hấp thụ an toàn các đợt bùng nổ lưu lượng (traffic spikes) bất ngờ do các job chạy đè lên nhau.
Đừng quên thiết lập công cụ giám sát (Observability) thông qua Prometheus và Grafana. Trong một pipeline phân tán, bạn cần theo dõi rõ ràng các nhóm Metrics: Độ trễ phân vị P95/P99 của Proxy, Tỷ lệ mã lỗi 429 theo thời gian thực, và Peak Memory của hệ thống. Một dashboard hiển thị rành mạch sẽ chỉ ra chính xác nút thắt cổ chai đang nằm ở khâu tính toán cục bộ, ở ổ cứng NVMe, hay đang ách tắc ở băng thông mạng bên ngoài.
Câu hỏi thường gặp (FAQ)
1. Tại sao nên dùng DuckDB 2.0 thay vì các phiên bản cũ cho Data Pipeline?
Phiên bản 2.0 trang bị kiến trúc Async I/O. Nó cho phép việc tải dữ liệu qua mạng và xử lý tính toán trên CPU diễn ra song song (gối đầu), khắc phục triệt để tình trạng CPU phải ngủ đông chờ mạng, giúp tăng tốc độ đọc S3/API lên gấp nhiều lần.
2. Đặt Datacenter Proxy trước VPS chạy DuckDB để giải quyết vấn đề gì?
Để chống lỗi HTTP 429 và cạn kiệt cổng kết nối TCP. Proxy đóng vai trò như bộ điều phối (Traffic Control), giúp phân luồng egress, quản lý rate-limit chủ động và phân tán rủi ro bị khóa IP diện rộng nhờ đa dạng hóa ASN.
3. Nên cấu hình RAM (memory_limit) bao nhiêu là an toàn trên VPS Linux?
Giới hạn ở mức 50% – 60% tổng RAM vật lý của máy chủ. Phần RAM trống còn lại là bắt buộc để hệ điều hành (OS page cache) hoạt động, ngăn chặn tiến trình OOM Killer đột ngột đánh sập pipeline khi hệ thống tải nặng.
4. Giao thức Quack của DuckDB 2.0 có tác dụng gì?
Quack biến VPS của bạn thành một Database Server thực thụ. Nó truyền tải dữ liệu nhị phân nguyên bản cực nhanh và hỗ trợ Remote Pushdown (đẩy các truy vấn nặng như JOIN, GROUP BY về xử lý trực tiếp tại máy chủ thay vì tải dữ liệu thô về client).
5. Lệnh Stateless Query (quack_query) mang lại lợi ích gì cho hệ thống?
Cho phép worker gửi lệnh SQL thẳng vào server và nhận kết quả dạng luồng (stream) mà không cần duy trì phiên kết nối (ATTACH/CONNECT). Điều này loại bỏ hoàn toàn rủi ro rò rỉ kết nối (connection leak) nếu worker đột ngột bị crash.
6. Có cần cài đặt biến môi trường HTTP_PROXY trên Linux để DuckDB nhận Proxy không?
Không. DuckDB không tự động đọc các biến môi trường mạng của hệ điều hành. Bạn bắt buộc phải định tuyến Proxy từ bên trong engine bằng câu lệnh CREATE SECRET hoặc SET http_proxy.
7. Có cần mua chứng chỉ SSL thủ công khi dùng Caddy Server không?
Không cần. Caddy Server tích hợp sẵn cơ chế tự động cấp phát và gia hạn chứng chỉ bảo mật Let’s Encrypt, giúp file cấu hình web server tinh gọn và tự động hóa hoàn toàn.
Kết luận
Việc triển khai kiến trúc DuckDB 2.0 trên VPS kết hợp chặt chẽ với cụm Datacenter Proxy mang lại một bước tiến vững chắc cho các kỹ sư dữ liệu. Bằng cách ủy thác việc điều phối lưu lượng mạng bảo mật cho Proxy, và giao phó khả năng tính toán gối đầu cho cơ chế Async I/O hiện đại, bạn hoàn toàn có thể kiến tạo một cỗ máy xử lý dữ liệu hạng nặng, luân chuyển trơn tru hàng TB dữ liệu mà vẫn giữ chi phí vận hành ở mức cực kỳ hợp lý.